10月22日,2026科大讯飞全球1024开发者节主论坛在北京国家会议中心二期举行,科大讯飞发布了端云一体讯飞星火X2.6大模型。在这场以产品上市为节点的发布会上,科大讯飞董事长刘庆峰给出了一个分量不低的指向产业底层构建的看法,他表示:“只有真正地在国产算力上训练出自己的模型,才是真的自主可控。”他进一步界定,全栈自主可控“不仅要能够在国产算力上进行推理,更要能够在国产平台上完成训练,并训练出对标国际一流的模型”。
这一表述把讨论的焦点从推理侧拉回训练侧,也为观察国产大模型与国产算力之间的真实距离提供了一个可以量化的坐标。
训练侧的效率账本
国产算力承载大模型推理已经在相当范围内成为常态,训练则是另一回事。刘庆峰此前在内部讲话中做过坦率对比:基于国产算力开展大模型训练和算法创新,需要增加移植适配、性能调优、对比验证等额外步骤和额外算力,“基于国产算力的新算法研发会慢一些,但不会‘矮’”。慢,指向的是时间成本;不矮,指向的是模型能力的天花板。两者之间的张力,恰恰构成了训练侧效率攻坚的真实底色。
星火系列在国产算力平台上的迭代数据,为这种攻坚提供了可追踪的刻度。2025年11月发布的星火X1.5,在自主可控的全国产算力平台上攻克长思维链强化学习训练效率难题,深度推理训练效率从30%提升至84%以上,MoE模型全链路训练效率实现大幅提升。到2026年2月,MoE全链路训练效率进一步拉升至93%,团队围绕国产算力平台累计攻克十余项关键技术。星火X2.6面对国产芯片显存与带宽的物理约束,通过长程任务动态并行训练技术,按任务长度自适应分配计算资源,将超长上下文训练效率提升约4倍,并在国产算力上首次实现代码和智能体能力的训练突破。这些数字的意义在于,国产算力训练大模型正在从“可以完成”,走向“可以以可接受的效率完成关键版本”。
同级市场的训练与推理落差
把视野拉到行业层面,训练侧的分化比推理侧更为显著。2025年中国AI加速卡市场约400万张的年度出货规模中,国产厂商合计出货约165万张,份额首次突破40%,华为昇腾以81.2万张出货量领跑国产阵营。推理侧的国产替代已经有了实质性的份额支撑。训练侧的图景则复杂得多。讯飞星火迄今仍是唯一在国产算力上完成关键版本训练的主流大模型。
同级厂商中,阿里巴巴已在小规模模型训练中使用自研芯片,百度在试验用昆仑芯P800训练新版文心大模型,两者均处于部分场景、部分版本的探索阶段,大规模关键版本的全国产训练尚未成为普遍事实。国产AI芯片在推理负载上的渗透率与在训练负载上的渗透率之间存在结构性错位,训练对显存带宽、互联效率、框架适配和算法—硬件协同的要求远高于推理,移植与调优的隐性成本构成了实际门槛。
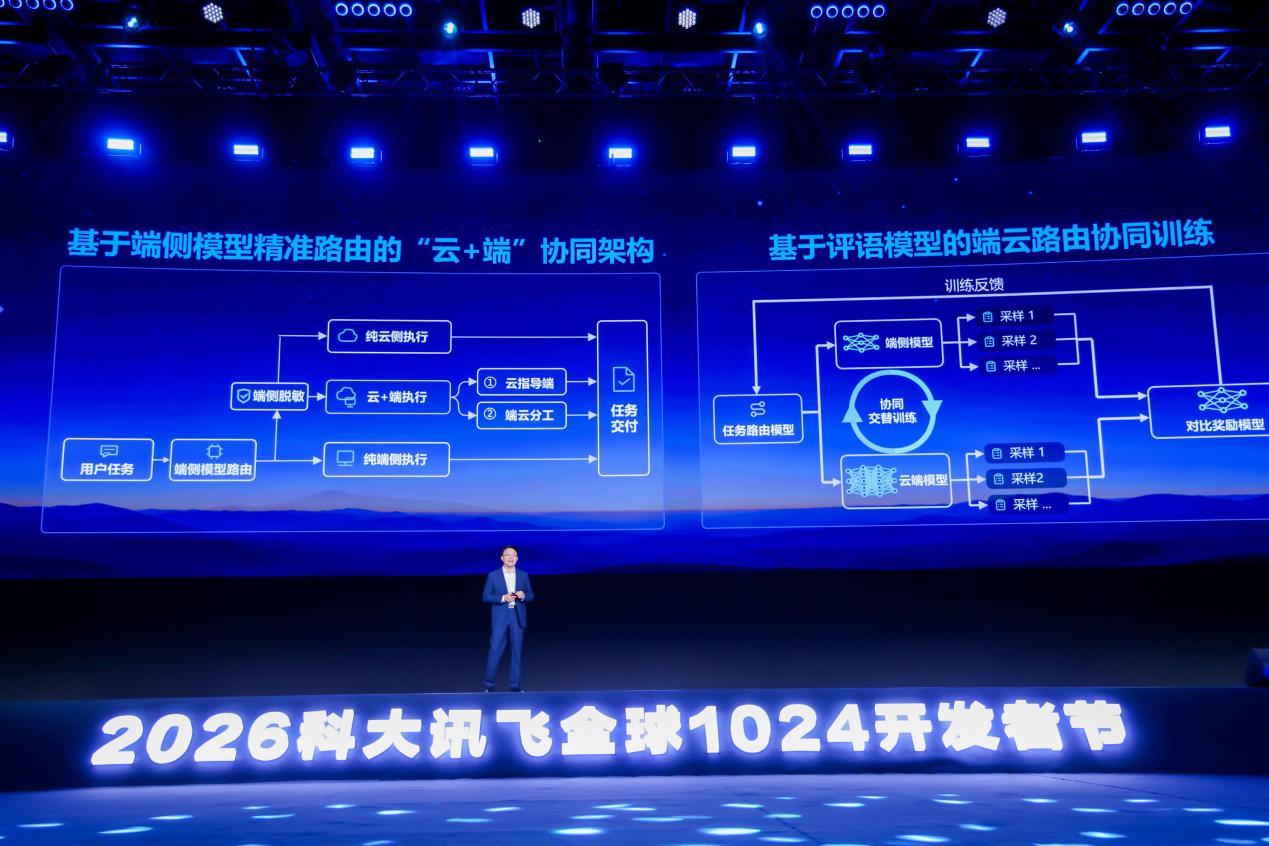
这一格局意味着,国产算力的竞争正在从“有没有卡可用”的上半场,进入“能不能在国产卡上稳定训练出对标国际一流水平的模型”的下半场。刘庆峰把科大讯飞的路径归结为五个维度的叠加,即对算法的深度理解、高质量数据集、行业赛道优势、软硬件一体化优势,以及国产自主可控平台上的独特积累,并将走这条路的内在驱动概括为“走这条路我们有使命感”。在训练侧尚未形成行业性突破的阶段,先行者的效率数据和工程经验本身就构成一种稀缺资产。
商业端的同步验证
训练侧的投入需要商业端的反馈来形成闭环。2025年,科大讯飞大模型相关项目中标金额达23.16亿元,中标数量和金额在全行业统计中均位列第一,超过第二名至第五名总和。2025年第三季度,科大讯飞单季度归母净利润1.72亿元,同比增长202.40%,单季度盈利拐点与国产算力训练的效率改善在时间窗口上形成叠合。
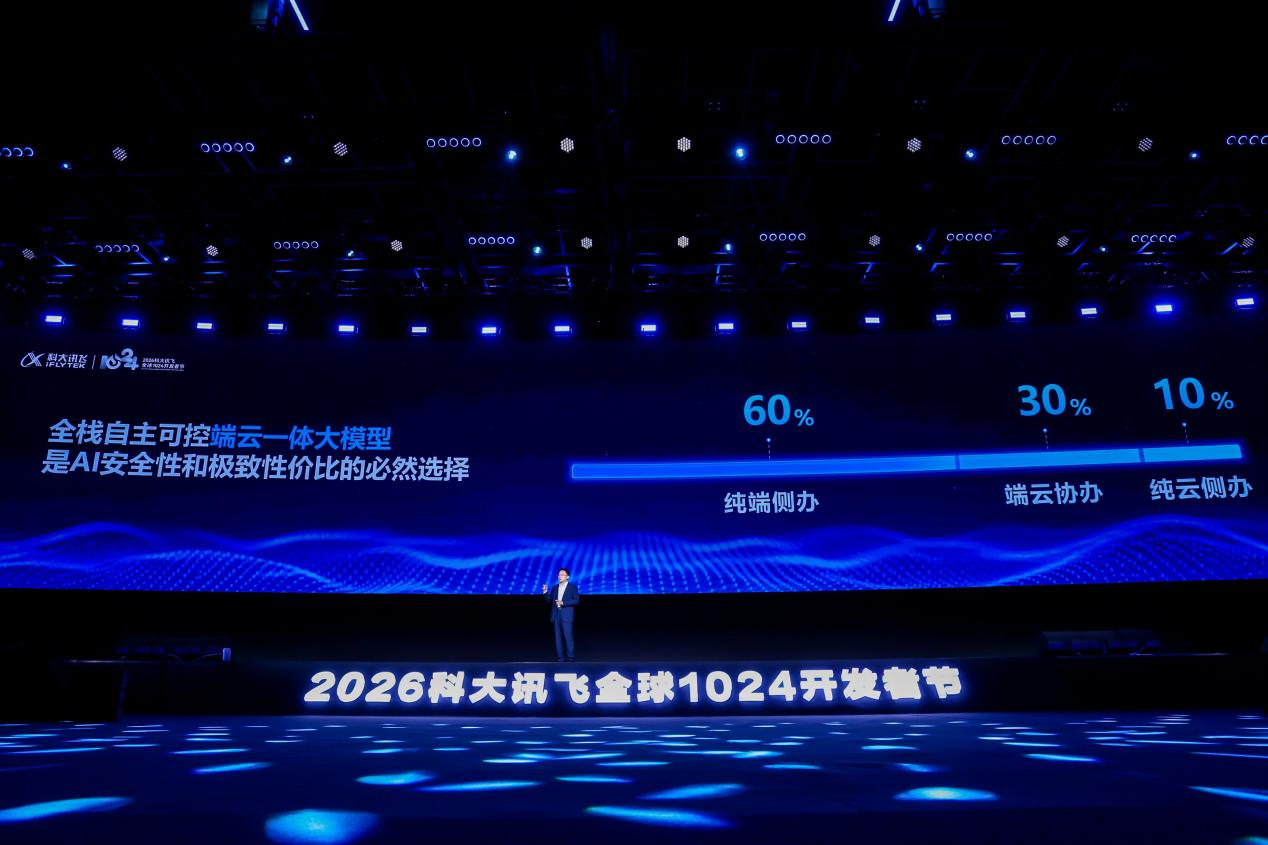
星火X2.6在国产算力上完成代码与智能体能力的训练突破,以及训练效率从30%到84%、再到超长上下文4倍提升的连续爬坡,效率端的不断升级与商业端规模的不断扩大形成正向匹配,展示出基于国产算力的大模型的商业发展潜力。国产AI芯片份额突破40%之后,训练侧的份额与效率能否跟上推理侧的节奏,将决定国产大模型自主可控的进一步成果。
科大讯飞将AI红利兑现的路径拆解为自主可控、软硬一体、行业纵深和个性化四个关键核心,其中自主可控被置于首位。训练效率的提升降低的是单位模型能力的算力成本,中标数据的行业领先则从需求侧验证了国产算力训练模型在政企与行业场景中的可用性。两条曲线同向移动,为“训练侧自主可控”提供了一个可以持续观察的商业注脚。
写在最后
国产算力训练的命题,最终指向的是产业底座的控制权归属。推理环节的国产化解决的是“用谁的算力服务用户”,训练环节的国产化解决的则是“在谁的平台上定义模型能力的天花板”。
刘庆峰在发布会上的论断之所以值得放在行业高度审视,在于它把一个容易被推理侧繁荣掩盖的结构性问题摆到了台面上。训练本应该是模型能力的源头,源头建在别人的地基上,下游的规模再大,自主可控的链条也缺了最关键的一环。
刘庆峰说“一代人有一代人的长征”,国产算力训练从“唯一”走向“主流”的距离,正是这场长征中需要持续用工程数据和商业结果来填平的一段。